[자료구조] B-tree
B-tree와 B+tree
B-tree란?
: 이진트리를 확장한 자료구조 탐색 성능을 높이기 위해 평소에 데이터들의 높이를 균형있게 유지하는 Balanced Tree의 일종이다.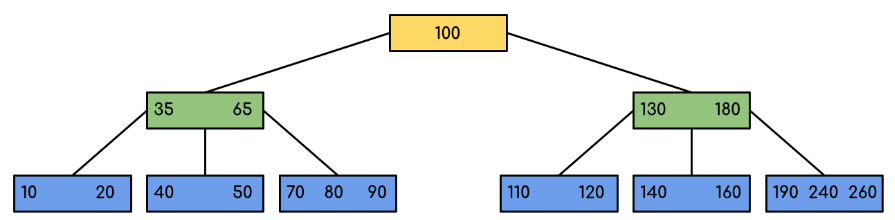
- 노드에는 2개 이상의 데이터(key)가 들어갈 수 있다.
- 하나의 노드가 가질 수 있는 자식의 최대 숫자가 2보다 크다.
- 모든 단말(leaf) 노드는 같은 레벨에 있어야 한다. 항상 균형을 유지한다 (균형 잡힌 트리).
- 최대 M개의 자식을 가질 수 있는 B 트리를 M차(M-way) B트리라고 한다. 내부 노드는 M/2 ~ M개의 자식을 가질 수 있다. (e.g. 3차 B트리 : 1~3개의 자식 노드 가능)
- 노드 내에 데이터(key)는 floor(M/2)-1개부터 최대 M-1개까지 포함될 수 있다
- 특정 노드의 데이터(key)가 K개라면, 자식 노드의 개수는 K+1개여야 한다.
 위의 그림은 3차 B 트리로, 각 노드에 데이터(key)와 그 자식들을 가리키는 포인터가 있다.
- 노드 안에서 데이터(key)는 항상 정렬된 상태를 유지한다.
- 이진 탐색 트리(BST)와 마찬가지로, 노드의 각 key의 왼쪽 자식은 자신보다 작고 오른쪽 자식은 자신보다 크다.
그래서 왜 쓰는데?
일반적인 트리인 경우 탐색하는데 평균적인 시간 복잡도로 O(log N)을 갖는다. 트리가 편향된 경우가 문제인데, **최악의 시간복잡도로 O(N)을 갖게 된다. 이러한 트리의 단점을 보완하기 위해 트리가 편향되지 않도록 항상 균형을 유지하는게 B 트리다. 자식들의 밸런스를 잘 유지하면 최악의 경우에도 O(logN)**의 시간이 보장된다.B 트리 연산들
탐색
https://www.cs.usfca.edu/~galles/visualization/BTree.html - 루트 노드부터 탐색 시작
- 노드안의 key를 순회하면서 K를 찾고, 존재하면 탐색을 종료
- K가 존재하지 않는다면, key들과의 값 비교를 한 후 그에 맞는 포인터를 통해 자식 node로 내려간다.
- leaf node까지 2~3을 반복한다.
e.g. 아래 트리에서 값이 14인 key를 찾아보자.


삽입
균형을 유지해야 하는 B 트리의 성질 때문에, key를 삽입하고 균형이 맞지 않는 경우엔 트리를 변형시켜야 한다. - 빈 트리인 경우, 루트 노드를 만들어 K를 삽입한다. root node가 가득 찬 경우, node를 분할하여 leaf node를 생성한다.
- K가 들어갈 leaf node를 탐색한다.
- 해당 leaf node에 자리가 남아있다면 정렬을 유지하도록 알맞은 위치에 삽입하고, leaf node가 꽉 차 있다면 K를 삽입한 후 해당 node를 중앙값을 기준으로 분할한다. 중앙값은 부모 node로 합쳐지거나 새로운 node로 생성되고, 중앙값을 기준으로 왼쪽의 key는 왼쪽 자식, 오른쪽의 key는 오른쪽 자식으로 생성된다.
e.g. 아까 트리에다 13을 삽입하는 과정

- 13이 들어갈 leaf node 탐색
- 정렬을 유지하는 위치에 삽입
- 한 노드에 들어갈 수 있는 key 수보다 많이 삽입된 상태이므로, 중앙값(13)을 기준으로 분할하고, 13은 부모 노드로 합쳐준다. 이 과정이 반복된다


시간복잡도
결국 핵심 연산은 탐색이고, 이 과정이 O(log n) 이기 때문에 삽입과 삭제 또한 O(log n). | | 평균 | 최악 | | --- | --- | --- | | 탐색 | O(log n) | O(log n) | | 삽입 | O(log n) | O(log n) | | 삭제 | O(log n) | O(log n) |B+tree란?
- B-tree의 확장개념
- 브랜치(중간) 노드에 key만 담아두고, data는 담지 않는 자료구조. 오직 리프 노드에만 key와 data를 저장한다. DB관점에서 생각해볼 때 레코드들은 모두 리프 노드에만 들어간다.
- 리프 노드끼리 Linked list로 연결되어 있다. 그래서 SQL에서 전체 조회를 할 때에도 속도가 빠르다.

- 데이터의 빠른 접근을 위한 인덱스 역할만 하는 중간 노드(internal node, index node)가 추가로 있음. index노드가 탐색시간을 줄여서 조건부 검색을 빠르게 해준다.
- 리프 노드를 제외하고는 데이터를 담아두지 않기 때문에 메모리 효율적이다.
- 하나의 노드에 더 많은 key들을 담을 수 있기 때문에 트리의 높이가 더 낮다.(cache hit를 높일 수 있음)
- SQL로 테이블 전체 조회를 할 때, B+tree는 전체 리프 노드들에 대해서만 한 번 선형탐색하면 되기 때문에 B-tree에 비해 빠르다. 반면 B-tree의 경우에는 모든 노드를 확인해야 한다.
InnoDB에서 사용된 B+tree
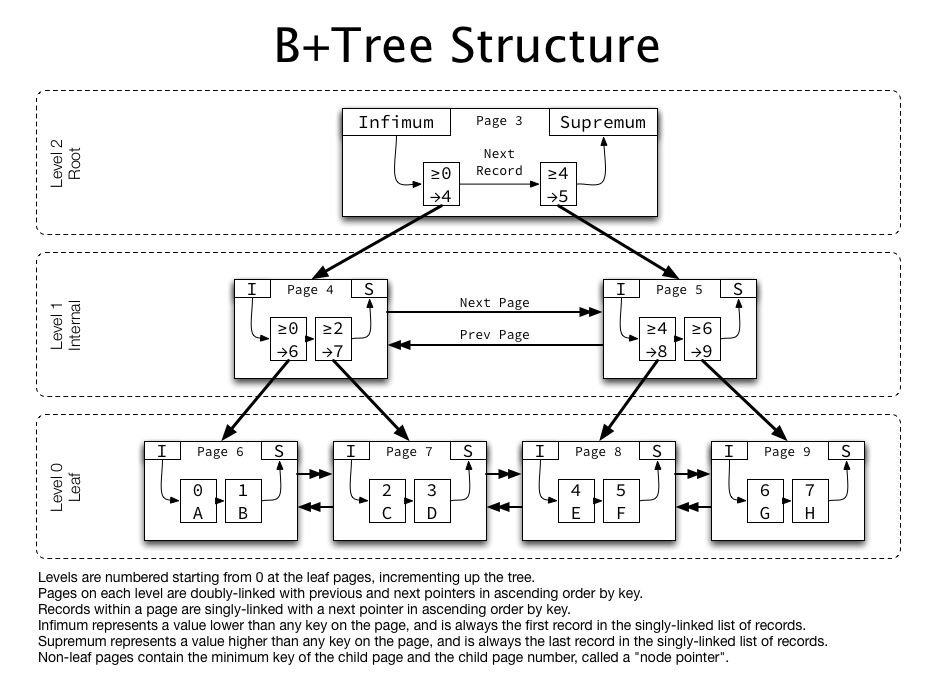 복잡하긴 하다. 같은 레벨의 노드들끼리는 Double Linked List를 사용했고, 자식 노드로는 Single Linked List로 연결되어있다.
key의 범위마다 찾아가야할 페이지 넘버(포인터)가 있는데, 해당 페이지 넘버를 통해 곧바로 다음 노드로 넘어간다.